scrapbook
面试必备知识
- 堆(Heap):一种基于树的数据结构,其中父节点的值与其子节点的值之间满足某种顺序关系。堆可以是最小堆(父节点的值小于或等于其子节点的值)或最大堆(父节点的值大于或等于其子节点的值)。
- 栈(Stack):操作遵循后进先出(LIFO)原则,即最后加入的元素最先被移除。栈可以用数组或链表实现。如果栈内存耗尽,则称为栈溢出(stack overflow)。
- 队列(Queue):操作遵循先进先出(FIFO)原则,即最先加入的元素最先被移除。队列可以用数组实现。
除了熟练掌握堆、栈和队列的实现外,清晰理解它们之间的区别也非常重要。在面试中,经常会遇到诸如“解释堆和栈的区别”之类的问题。
堆(Heaps)
什么是堆?
最小堆(min-heap)用于存储具有偏序关系的对象。它能够以较快的速度(O(log n))从堆中移除最小对象。最小堆适用于需要多次执行最小值计算的场景。
与之对应的还有最大堆(max-heap),用于提取堆中的最大值。
一个堆只能是最大堆或最小堆——不能同时是两者。给定一个最小堆的实现,只需反转元素间的比较逻辑即可实现最大堆。本文后续内容仅讨论最小堆。
堆有时也被称为优先队列(priority queue)。严格来说,堆只是优先队列的一种实现方式。
关键术语
- 键(key):决定顺序的值。如果存储的是数字,数字本身就可以作为键;如果存储的是更复杂的对象,则用于比较的数据字段就是键。与哈希表不同,堆中的键不需要唯一。
- extract_min:快速从最小堆中提取并移除最小元素的方法。
关于堆的一些实现细节(如堆性质和完全二叉树)对于从零开始构建堆很有帮助,但在使用堆解决面试题时通常不太重要。
优缺点
优点
- 最小堆能快速提取堆中的最小值。对最小堆反复执行提取操作并存入数组,最终会得到一个有序数组。
缺点
- 在堆中没有便捷的方法来查找某个特定的键值。堆中的元素只是部分有序;虽然可以利用堆的性质进行一定程度的搜索剪枝,但无法高效完成任意查找。
面试中何时使用堆?
堆的设计目标非常明确:高效地重复提取最小(或最大)值。因此,“何时使用堆”的答案总是类似的:当你需要重复提取最小值(或最大值)时就用堆。尽管具体问题形式可能千差万别,但核心思想一致。以下是一些常见的适合使用堆的面试题示例:
在图中找到两个节点之间的最短路径:
标准解法是 Dijkstra 算法。该算法的关键步骤之一是从尚未处理的节点中选择距离起点最近的节点,这本质上是一个最小值查找操作。获取下一个即将发生的事件:
将事件以时间戳为键存入堆中,就能快速提取下一个事件(时间戳最小的事件最先发生)。在数据流中动态维护中位数:
这是“动态中位数”问题,通常用两个堆维护:一个最大堆保存小于当前中位数的值,一个最小堆保存大于当前中位数的值。插入新值时,根据大小放入相应堆,并在必要时调整两个堆的大小,使其元素数量最多相差1。在一次遍历中找出字符串中前
k个不重复的字符。
常见操作速查表
下表描述的是基于完全二叉树实现的最小堆的操作。最大堆的操作类似,只需将比较逻辑反转。
| 操作 | 描述 | 时间复杂度 | 是否修改结构 |
|---|---|---|---|
insert(key) |
将 key 插入堆中。可扩展为支持 key/value 对。 |
O(log n) |
是 |
extract_min() |
返回并移除堆中键最小的元素。 | O(log n) |
是 |
peek_min() |
查看最小键值,但不移除。 | O(1) |
否 |
heapify(list) |
从包含 n 个元素的列表构建新堆。功能上等价于从空堆逐个插入,但时间复杂度优于逐个插入的 O(n log n)。 |
O(n) |
不适用(创建新堆) |
还有其他堆的变体(如二项堆和斐波那契堆),可在渐近时间复杂度上略有优化,但支持的操作基本相同。
栈和队列(Stacks and Queues)
什么是栈和队列?
栈和队列常被归为一类,因为它们有许多共性:都是用于存储元素并按特定顺序返回的数据结构。它们的核心区别在于元素的取出顺序。
栈是“后进先出”(LIFO):
想象一摞书。你把一本书放在最上面,就必须先拿走它才能拿到下面的书。最底下的书只有在上面所有书都被移除后才能访问。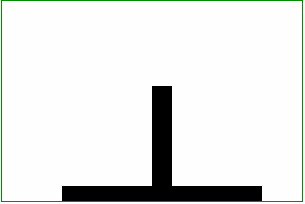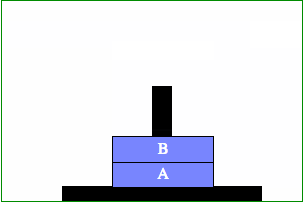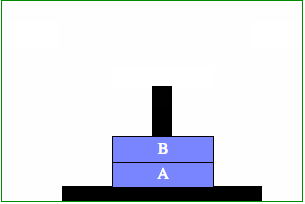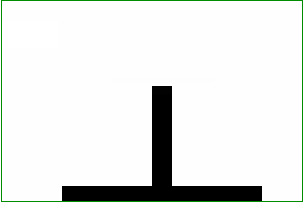
如果按顺序
[A, B, C, D, E]将元素压入栈,在全部压入后再依次弹出,顺序将是[E, D, C, B, A]。队列是“先进先出”(FIFO):
就像银行排队:先到的人先被服务。用队列存储数据时,先进入的元素先被取出。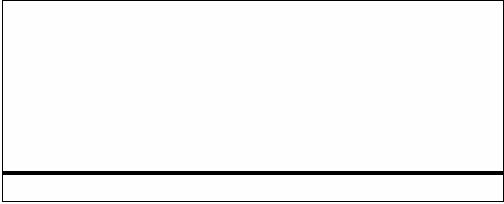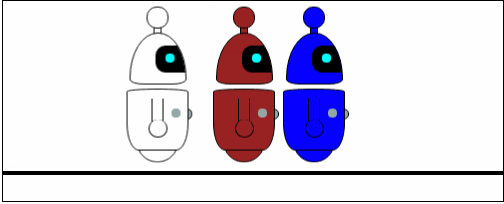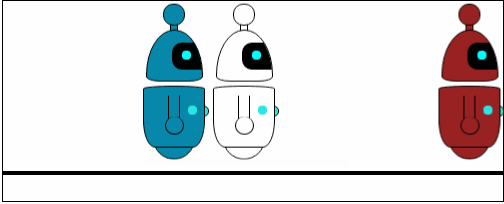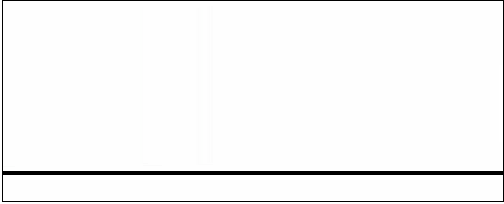
如果按顺序
[A, B, C, D, E]入队,那么出队顺序也是[A, B, C, D, E],即使入队和出队操作交错进行也是如此。(动画中显示元素“向前移动”,但在高效实现中,未出队的元素保持原位,因此出队操作可达到
O(1)时间复杂度。)
由于这些比喻,我们常说栈有“顶部”和“底部”,而队列有“前端”和“后端”。
栈和队列都是抽象数据类型(ADT),这意味着只要能保证按指定顺序添加和取出元素,底层可用任意数据结构(如数组或链表)实现。例如,在 Python 中,标准列表既可当作数组,也可当作栈使用。
关键术语
栈和队列都有添加和移除操作,但名称不同:
- push(栈):将对象添加到栈“顶部”。
- pop(栈):从栈“顶部”移除对象。
- enqueue(队列):将对象添加到队列“后端”。
- dequeue(队列):从队列“前端”移除对象。
具体函数名可能因实现方式或编程语言而异。例如,在 Python 中使用列表模拟栈时,L.append(item) 相当于 push,而 L.pop() 就是 pop。
一种巧妙的实现是使用双向链表,并维护头尾指针。这样可以在 O(1) 时间内实现上述所有四个操作。
常见操作速查表
由于栈和队列是抽象数据类型,关于是否应规定其操作的时间复杂度存在一些争议。争议点在于:这些操作的时间复杂度是否属于定义的一部分,还是仅仅是实现细节。下表采用实用主义观点,将时间复杂度纳入定义——因为你选择栈或队列,正是看中了它们能高效地按特定顺序增删数据。
注意:如果你使用的是多功能数据结构(如 Python 的 list,它既是栈又是队列),而非专门优化的栈或队列实现,实际性能可能比下表所示更差。
栈操作
| 操作 | 描述 | 时间复杂度 | 是否修改结构 |
|---|---|---|---|
push(item) |
将 item 压入栈顶 |
O(1) |
是 |
pop() |
移除最近添加的元素(即栈顶元素) | O(1) |
是 |
peek() |
访问栈顶元素但不移除 | O(1) |
否 |
isEmpty() |
若栈为空返回 True,否则返回 False |
O(1) |
否 |
队列操作
| 操作 | 描述 | 时间复杂度 | 是否修改结构 |
|---|---|---|---|
enqueue(item) |
将 item 加入队列尾部 |
O(1) |
是 |
dequeue() |
移除队列前端的元素 | O(1) |
是 |
peek() |
访问队列前端元素但不移除 | O(1) |
否 |
isEmpty() |
若队列为空返回 True,否则返回 False |
O(1) |
否 |